用网页版的 AI 聊天,多少有点顾忌。工作里带点内部信息的材料、家里的事、没定下来的计划,都得想想再往对话框里贴。想换个不联网的方案,一搜"本地部署大模型",跳出来的教程全是命令行,看两行就劝退。
我刷 GitHub 新仓库榜的时候看到一个项目,名字叫 Strata,干的就是这件事:把一个通常要服务器才带得动的大模型,装进你家里那台普通电脑。它是 GitHub 近 30 天新建仓库总星榜的第 3 名——建仓不到一个月,截至榜单抓取那天已经攒了 2.5 万颗星,平均一天一千多。据项目 GitHub 页介绍,它跑的是 Qwen3.8-Flash-Next——阿里千问团队的开源模型,1250 亿参数,能聊天、写东西、读图。Strata 本身也是开源的,MIT 许可证,不收钱。
先说你能不能装。官方 README 给的门槛是:NVIDIA 或 AMD 显卡、12GB 显存起步,内存 32GB 起,硬盘留 80GB 出头,系统 Windows 或 Linux。对着一台三年内的游戏电脑,这基本就是它的常规配置。两三张显卡也能一起扛一个模型,旧显卡有社区写的实验性支持。
官方 README 的演示视频里,一块 RTX 5070 显卡用一句提示词生成了一座体素宝塔花园,长这样:
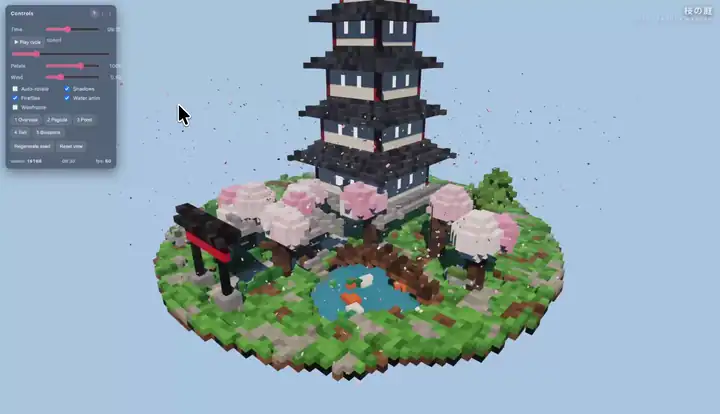
官方演示图:单次提示词在 RTX 5070 上生成的体素宝塔花园(图源:项目官方 README)
装好之后怎么用?浏览器打开一个本地地址就能聊,界面里有聊天窗口和实时状态面板。它还提供兼容 OpenAI 和 Anthropic 的接口——这两个名字是行业里最常用的两种"接 AI 的标准插口"——意思是,你平时用的那些能接 AI 的应用和编程助手,把服务器地址改成本机,一样能接上它。官方 README 的原话是 Nothing leaves your PC,什么都不离开你的电脑。
速度方面,官方在两台游戏 PC 上做了测量:一块 RTX 5070 显卡、64GB 内存的机器,生成回答每秒 94 个词元(一个词元约等于四分之三个汉字或单词),README 里说这个速度比人的阅读速度还快。数字都是官方自测的,你机器上跑出来多少,可以用它自带的测速脚本量一遍。
它解决的就是两个老问题:数据不出门,API 不按月交钱(API 就是按调用量付费的远程接口)。自己的电脑,自己的文件,随便聊。
顺便说下它为什么装得下:这种模型内部由两万多个小"专家"组成,每答一句只用到其中十来个。官方文档解释,Strata 把最常用的放在显卡、全部放在内存、剩下的交给处理器和硬盘分工处理,再用一个小模型先猜答案、大模型一次性校验,速度还能提 1.6 到 1.8 倍。原理图长这样:
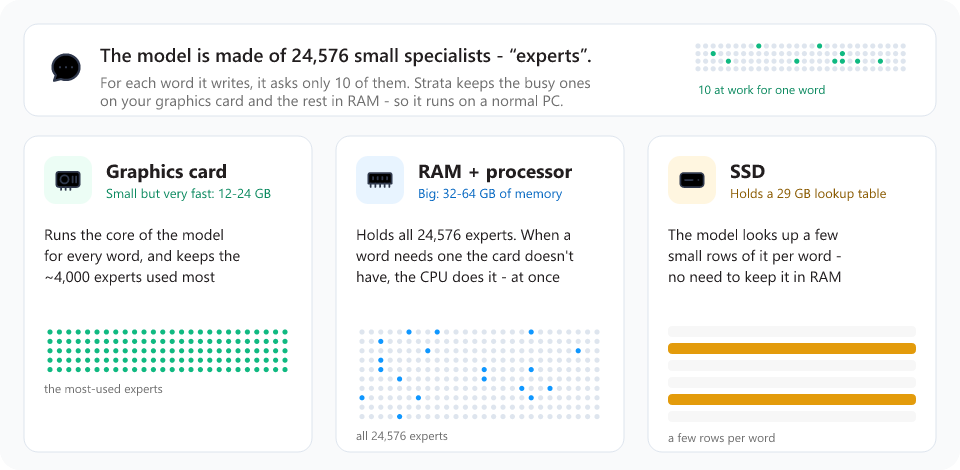
官方原理图:模型的两万多个"专家"如何分摊到显卡、内存、处理器和 SSD 上(图源:项目官方 README)
安装这块这篇项目做得特别贴心:官方 README 专门写了一节"让你的 AI 帮你配置"。你只要在装好 Claude Code、Cursor 这类 AI 编程助手的电脑上,把 README 里给的那句话粘过去,AI 会自己检查你的显卡、内存和磁盘,选一款合适的模型规格,装好、启动,再告诉你怎么接进应用。没有这类工具的,把 README 整页复制给豆包或 Kimi,让它当向导带着你点,也是一样的路子。按官方说法,模型文件要下 70GB 左右,中途断了不用慌,重新跑一次安装会接着下。
有两个官方特别提醒的坑,提前说:模型启动那 1 到 3 分钟,电脑可能卡住不动,这是正常现象,别关窗口;关掉软件就是停止模型,下次再开不会重新下载。
模型是国产的千问,引擎是开源的,数据留在自家硬盘里。我先看明白了,你跟上。