假如你开网店,每天几百条客户留言涌进来:谁要退款、谁的账号出问题了、谁在威胁差评。每条都要人看人分派,累;让 AI 大模型来分,一条几秒钟、按量收费,一个月账单不便宜——而且它有时候还会"编"。这个两头堵的麻烦,GitHub 上有个 3.3 万星的新项目,给出了第三种做法。
先说它凭什么上榜:Laya 是 2026 年 9 月 18 日建的仓库,不到一个月拿下 3.3 万颗星,排 GitHub 近 30 天新建仓库总星榜第 2 名。开源,Apache-2.0 许可,免费用。
它是干什么的?据项目 GitHub 页介绍,Laya 是一个"决策引擎":给它一段文字(客户留言、邮件、工单、任意文档),它回答你预先设定好的问题——从几个选项里挑一个(这单该给账务部还是技术部)、打个分(这事有多急)、回答是与否(这个人是不是在威胁要走)。官方 README 给的数字:单个判断 33 毫秒,批量做平均每个 7.2 毫秒,支持 100 多种语言。
关键差别在于它的工作方式。大模型(比如 ChatGPT 那类)回答问题是一个字一个字往外蹦的,行话叫"生成",所以慢、贵,还会生成出不存在的内容——就是"幻觉",AI 一本正经地编瞎话。Laya 不生成任何文字,它对文本直接算出答案,一次算完,33 毫秒。没有文字生成,也就没有幻觉,没有解析失败,用官方的对比图看,在公开数据集上的准确率、速度、稳定性各项指标都有得比:
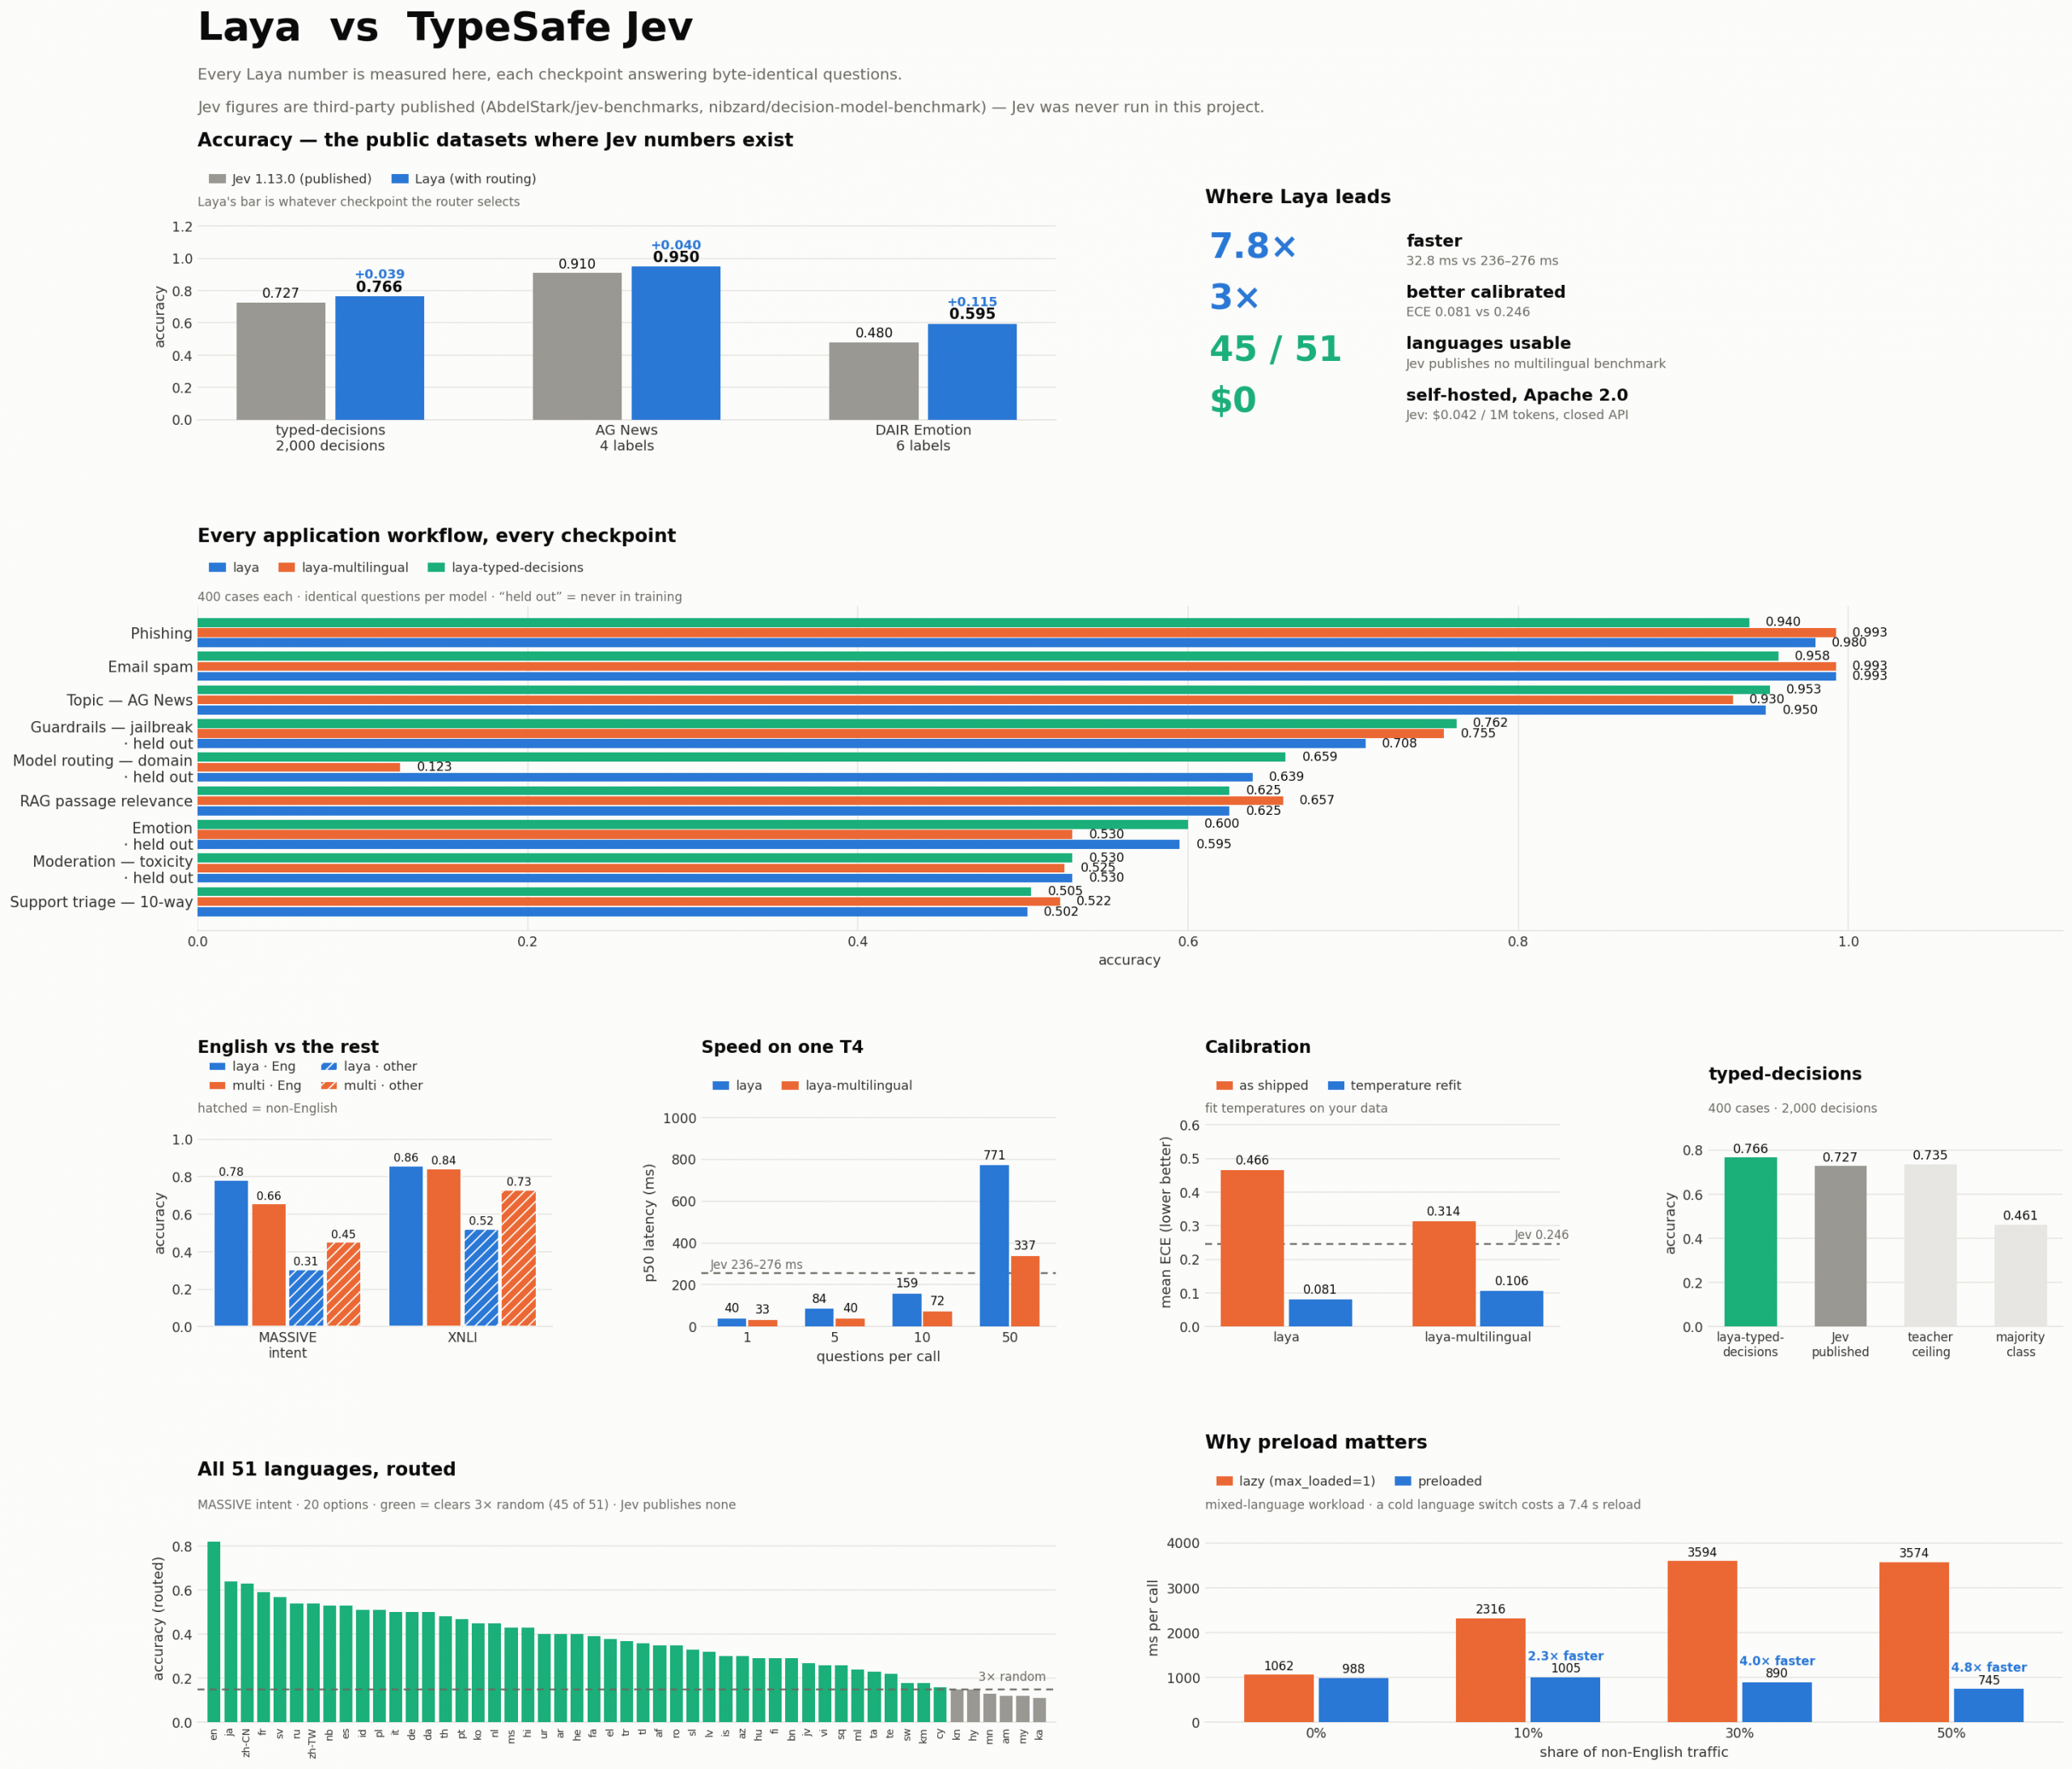
官方基准图:Laya 与同类模型在准确率、速度、语言覆盖、校准等维度的对比(图源:项目官方 README)
功能官方 README 列得相当全,挑重点说:内置一个路由器,会按你输入的语言自动挑合适的模型,英语走英语版,中文等一百多种语言走多语言版;长文档模式能读 8000 多个词元,官方给的长文档测试图在这——
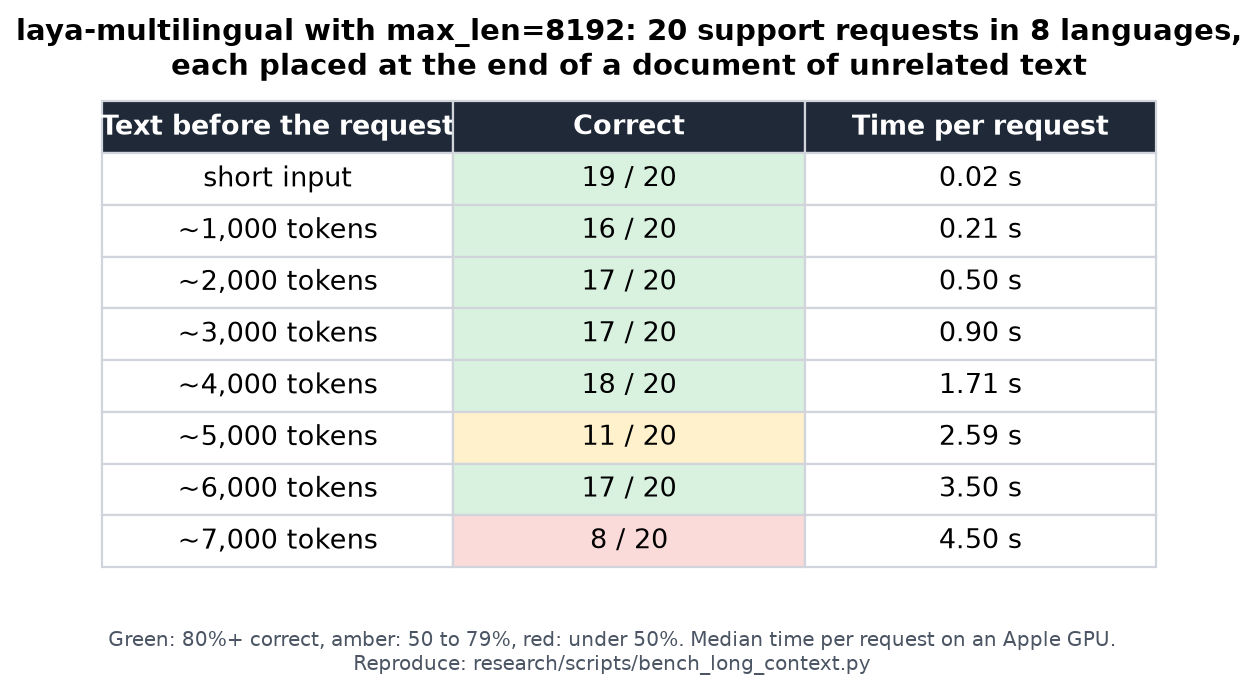
官方测试图:长文档场景下,文本放在前部约 4000 词元以内时 20 次能对 16 到 18 次(图源:项目官方 README)
它还能在自己业务的数据上微调(官方数字:微调后准确率从 0.362 提到 0.766),附带 HTTP 服务器、MCP 服务器和 LangChain 等主流 AI 框架的现成集成;除了 Python 还有 Node.js 版。
想装它,路径很清楚:电脑上有 Python(一种编程运行环境)的话,一行命令 python -m pip install laya,要求 Python 3.10 以上。更省心的方式照旧——把项目 README 整页复制给 AI 助手,让它带你装、带你写第一个判断脚本;用 Claude Code、Cursor 这类编程 AI 的,直接说"帮我装 Laya 并写一个把客户留言分类的脚本",它从头包到尾。装好之后,Laya 自带 MCP 服务器,可以把"判断能力"接到你的 AI 助手上——让大模型负责写和聊,让 Laya 负责快判断,各干各的强项。
它不是给纯小白的玩具,但你不用会写代码也能让 AI 帮你把它用起来。判断类的活值多少钱,你的账单最清楚。我先看明白了,你跟上。